Материал: Система поддержки принятия инвестиционных решений малого предприятия. Баркалов С.А., Морозов В.П
4.4. Алгоритм обмена данными между бд
Блок-схема алгоритма обмена данными между ОБД и ДБД, реализованного в модуле «Оптимизация доступа», представлена на рис. 4.3.
Блоки 1,8 используются для пуска и остановки процесса обмена данными.
В блоке 2 реализован ввод исходных данных, таких как значение верхнего уровня объема данных ОБД; значение нижнего уровня объема данных ОБД. Запуск и остановка процедуры перемещения данных реализуется в соответствии со следующими критериями:
• система перемещения данных из ОБД в ДБД запускается, если общий объем хранимых в ОБД данных превышает верхний допустимый уровень;
• система перемещения данных из ОБД в ДБД прекращает работу, когда

общий объем хранимых в ОБД данных становится меньшим, чем нижний допустимый уровень.
Блок 3 используется для проверки состояния загруженности ОБД. Если ОБД не загружено, то осуществляется переход к блоку 5. В противном случае управление переходит к блоку 4.
Блок 4 реализует архивацию и перемещение данных из ОБД в ДБД.
В блоке 5 реализован поиск данных, запрашиваемых пользователем. Если они содержатся в ОБД, то осуществляется их непосредственная загрузка и дальнейшая работа с ними. В случае их размещения в ДБД управление передается блоку 6.
Блок 6 используется для поиска запрашиваемых данных в ДБД. В случае их наличия, последние перемещаются из ДБД в ОБД, распаковываются (разархивируются) и предоставляются пользователю для дальнейшей работы.
Блок 7 реализует запись полученных оперативных данных в ОБД.
Большое значение при архивации данных имеет определение последовательности их переноса. В ДБД переносятся не все данные - об этом свидетельствует наличие нижнего допустимого уровня хранения данных в ОБД. Перемещение производится в соответствии с рангом популярности данных: очередь на перенос формируется в очередности, обратной популярности данных, которую имеют данные с минимальным рангом. В качестве меры популярности использовалась эмпирическая оценка вероятности поступления запроса: чем выше вероятность поступления запроса, тем выше ранг данных.
Для оценки вероятности поступления запроса использовано предположение о том, что запросы формируют поток событий, подчиняющийся статистике простого пуассоновского потока [1-3, 84]. В рамках данного предположения интенсивность потока (количества событий в единицу времени) запросов на i- й набор данных определяется в соответствии со следующей эмпирической оценкой:
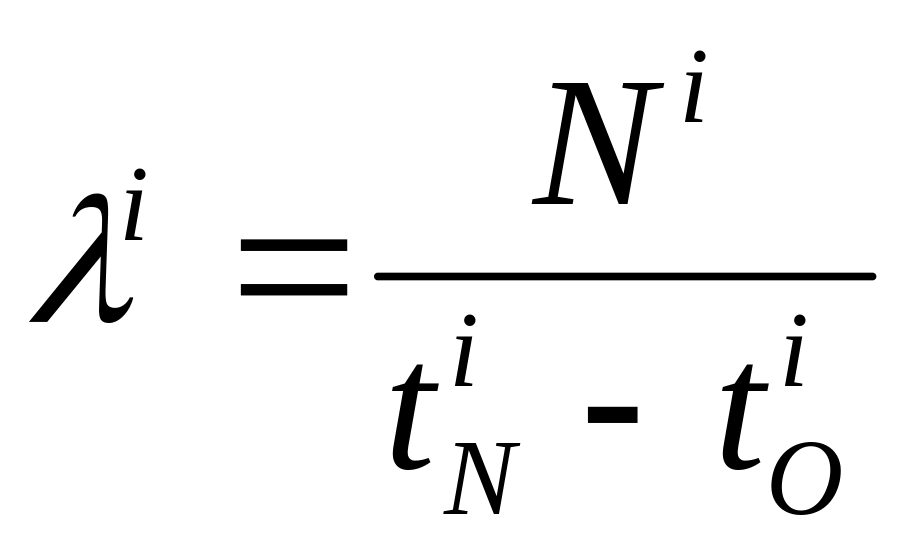 , (4.1)
где
Ni
- полное количество запросов на i
- й набор
данных,
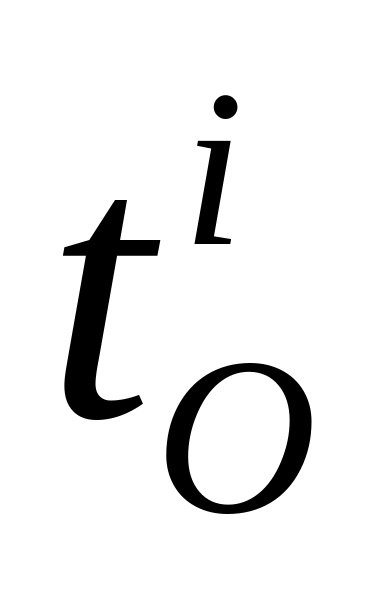 - время поступления данных в архив,
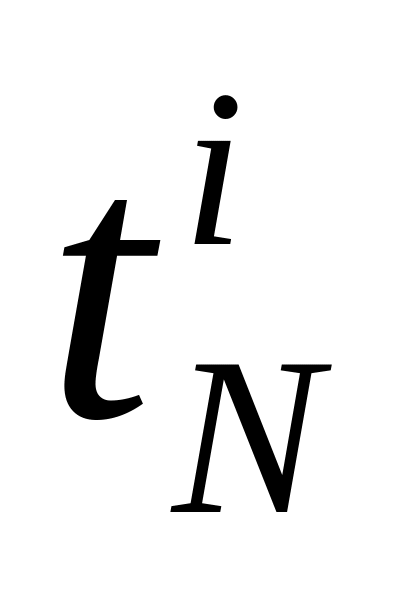 - время поступления Ni
-го
запроса. Вероятность поступления запроса
на i
- й набор данных при интенсивности потока
заказов
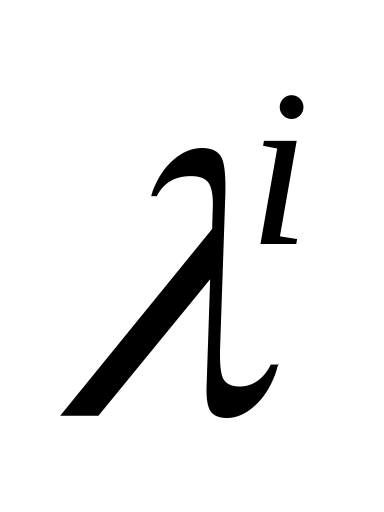 в момент времени
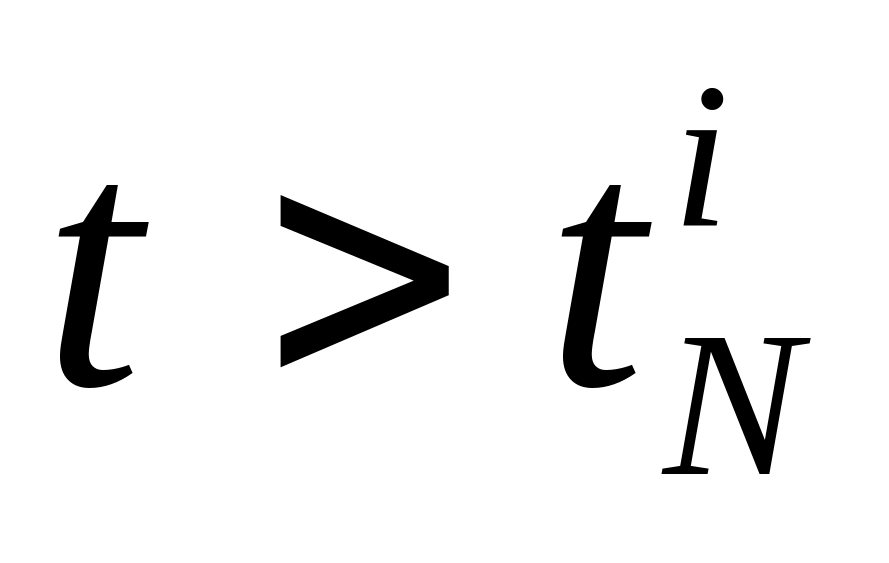 определяется выражением (вероятность
единичного события на интервале
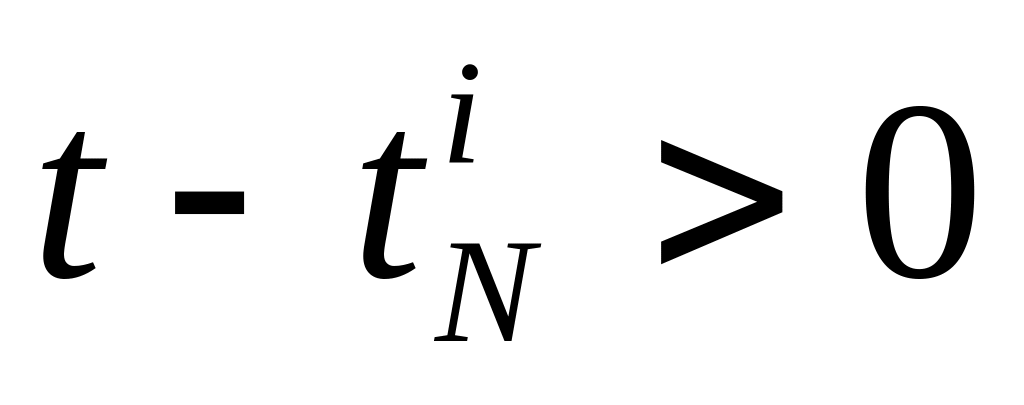 ) [1]
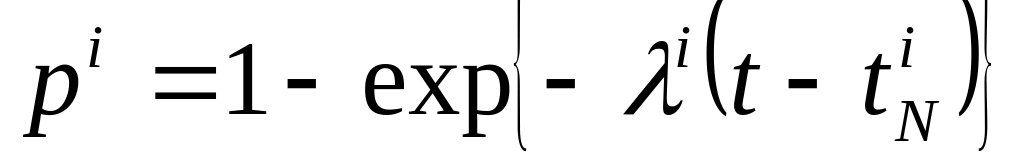 . (4.2)
Полученные оценки определяют ранг набора данных. Для множества из K наборов данных ранжирование сводится к сортировке данных в соответствии с правилом:
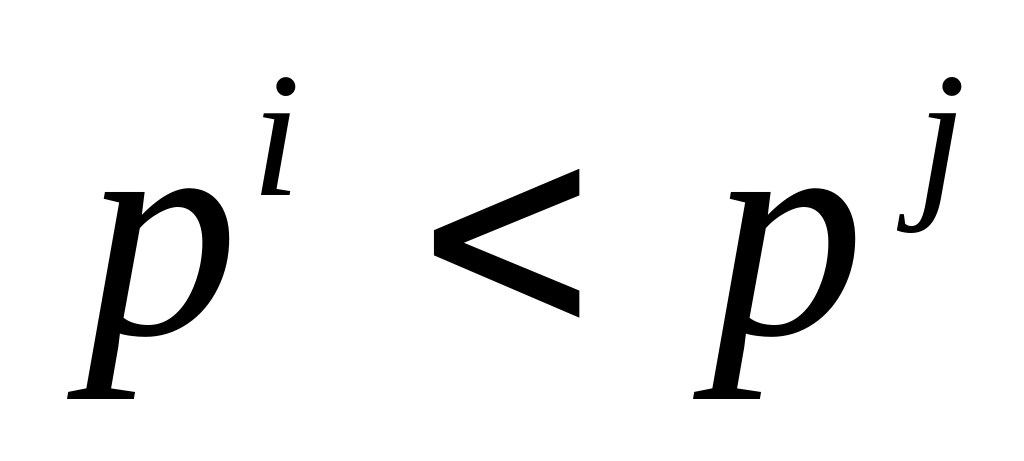 ,
при i<j
для любых
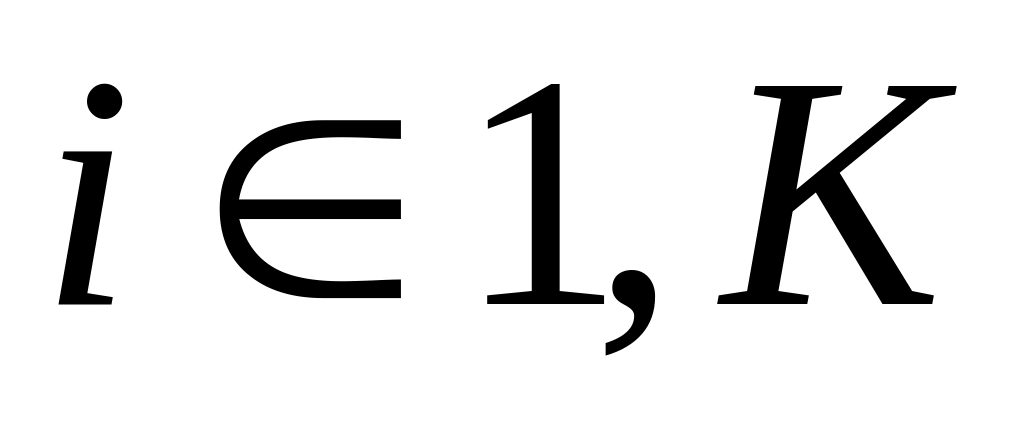 ;
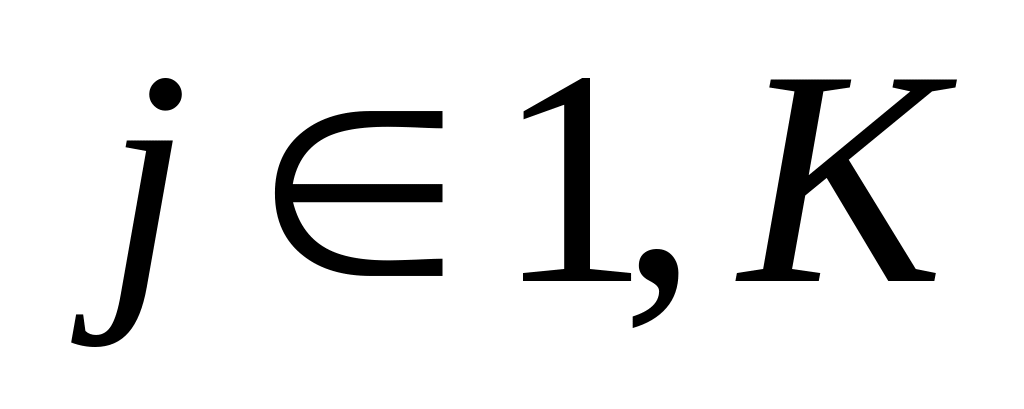 . (4.3)
В результате данной сортировки наборов данных набор с индексом i является искомым, который необходимо перенести в ДБД. В этом случае минимизируются расчетные затраты на повторное извлечение данных из ДБД. При реализации данного алгоритма сортировка проводится при потенциально большом количестве кандидатов на перенос. В случае, когда количество переносимых файлов (наборов данных) невелико, реализуется простой последовательный перенос файлов, имеющих минимальные вероятности поступления заказа.
Предложенный подход реализован в виде набора процедур, обеспечивающих:
1) контроль ресурсов ОБД;
2) расчет ранга популярности данных;
3) автоматический перенос данных, инициируемых процедурами контроля состояния ОБД.
4.5. Эвристическая оптимизация структуры базы данных
При разработке модели данных был использован стандарт IDEF0 [75].
В IDEF0 система представляется как совокупность взаимодействующих работ или функций. Функции системы анализируются независимо от объектов, которыми они оперируют. Это позволяет более четко смоделировать логику и взаимодействие процессов организации [76, 77]. Основу методологии IDEF0 составляет графический язык описания бизнес-процессов. Модель в интерпретации IDEF0 представляет собой совокупность иерархически упорядоченных и взаимосвязанных диаграмм [29]. Каждая диаграмма является единицей описания системы и располагается на отдельном листе. При разработке информационных моделей ОБД и ДБД использовались модели «сущность-связь» (ER-модели) [68]. Модель "сущность-связь" представляет собой высокоуровневую концептуальную модель данных. Данная модель – это набор концепций, которые описывают структуру БД и связывают с ней транзакции обновления и извлечения данных. На основании модели «сущность-связь» были построены таблицы для занесения данных. Таблицы строились с помощью программного средства Database Desktop в среде визуального программирования Delphi 7.0 с использованием Paradox 7. Процесс их проектирования проводился с помощью программы BP-Win [68] и затруднений не вызывал в отличие от оптимизации их структур. Для реализации последнего был разработан специальный алгоритм эвристической оптимизации, блок-схема которого представлена на рис. 4.4.
Блоки 1 и 8 используются для пуска и остановки алгоритма эвристической оптимизации структуры базы данных.
В блоке 2 реализован ввод исходных данных, таких как число уровней нормализации и число индексируемых полей.
В блоке 3 реализована многоуровневая нормализация БД. Нормализация - это формальный метод анализа отношений на основе их первичного ключа и существующих функциональных зависимостей. В ходе нормализации формат отношений становится все более ограниченным (строгим) и менее восприимчивым к аномалиям обновления. В теории реляционных баз могут использоваться 5 нормальных форм. Любой нормальной форме соответствует известный набор ограничений. Отношение находится в определенной нормальной форме, если оно удовлетворяет набору ограничений этой формы. С переводом структуры отношений базы данных в формы более высокого порядка происходит удаление из
таблиц избыточной неключевой информации [135].
Первая нормальная форма (1НФ) - отношение, в котором на пересечении каждой строки и каждого столбца содержится одно и только одно значение.
Вторая нормальная форма (2НФ) - отношение, которое находится в первой нормальной форме и каждый атрибут которого, не входящий в состав первичного ключа, характеризуется полной функциональной зависимостью от этого первичного ключа
Третья нормальная форма (ЗНФ) - отношение, которое находится в первой и во второй нормальных формах и не имеет атрибутов, не входящих в первичный ключ атрибутов, которые находились бы в транзитивной функциональной зависимости от этого первичного ключа.

Четвертая нормальная форма (4НФ) - отношение в нормальной форме Бойса-Кодда, которое не содержит нетривиальных многозначных зависимостей.
Пятая нормальная форма (5НФ) - отношение без зависимостей соединения.
Чтобы избежать аномалий обновления, нормализацию рекомендуется выполнять как минимум до третьей нормальной формы (ЗНФ) [36]. Также третья нормальная форма (3НФ) служит компромиссом между полной нормализацией и функциональностью в совокупности с легкостью реализации. Нормальные формы, выше третьей, затрудняют разработку структур данных и снижают их функциональность. Поэтому была проведена нормализация до ЗНФ.
Блок 4 обеспечивает проверку достаточности уровня нормализации БД. Если он достаточен, то управление передается в блок 5. В противном случае управление передается в блок 3.
В блоке 5 реализовано индексирование БД. Индекс – это структура данных, которая помогает системе управления базами данных быстрее обнаружить отдельные записи в файле и сократить время выполнения запросов пользователей. Индекс в базе данных аналогичен предметному указателю в книге. Он позволяет избежать проведения последовательного или пошагового просмотра файла в поисках нужных данных. Как и предметный указатель книги, индекс базы данных упорядочен, и каждый элемент индекса содержит название искомого объекта, а также один или несколько указателей (идентификаторов записей) на место его расположения. Индекс занимает намного меньший, чем таблица объем памяти, поэтому даже полный перебор значений в нем является более быстрой операцией, чем считывание и поиск информации в отношении. Кроме того, значения в индексе хранятся упорядоченно, что позволяет ускорить поиск нужной строки. Индексы дают возможность выбирать строки отношений, значения индексируемого атрибута которых принадлежит некоторому заданному интервалу. Для одного отношения может быть создано несколько индексов. Если разные отношения содержат одинаковые атрибуты, то для них может быть сформирован мультииндекс. В нем каждому значению общего атрибута соответствует несколько ссылок, каждая из которых указывает на строку с таким значением в том или ином отношении.
Блок 6 обеспечивает проверку уровня достаточности индексирования БД. Если он достаточен, то управление передается в блок 7. В противном случае управление передается в блок 5.
Блок 7 обеспечивает вывод результатов. В качестве результатов выступает оптимизированная БД.
В качестве примера в табл. 4.2 приведены данные, хранящиеся в БД, предназначенные для обучения искусственной нейронной сети. В качестве данных приведены значения котировок акций ОАО «Газпром», имевших место в период с 25.03.2011 по 04.04.2011 г.
Таблица 4.2
Данные, хранящиеся в БД для обучения ИНС
Дата |
25.03.11 |
28.03.11 |
29.03.11 |
30.03.11 |
31.03.11 |
01.04.11 |
04.04.11 |
Цены открытия |
224,87 |
223,01 |
225,9 |
225,51 |
229,38 |
229,1 |
235,98 |
Норм. цена открытия |
0,23 |
0,15 |
0,27 |
0,26 |
0,42 |
0,40 |
0,69 |
Цены закрытия |
222,81 |
225,5 |
224,01 |
229,32 |
229,09 |
235,1 |
237,7 |
Норм. цена закрытия |
0,11 |
0,22 |
0,16 |
0,38 |
0,37 |
0,62 |
0,73 |
Прогнозная цена |
223,01 |
225,9 |
225,51 |
229,38 |
229,1 |
235,98 |
238,46 |
Норм. прогноз |
0,14 |
0,26 |
0,25 |
0,41 |
0,40 |
0,68 |
0,79 |
В строках данной таблицы используются значения таких характеристик, как:
- «Дата» – дата, на которую приведены значения акций;
- «Цена откр.» – цена за акцию на момент открытия торгов;
- «Цена закр.» – цена за акцию на момент закрытия торгов;
- «Прогнозная цена» – цена открытия торгов на следующий день, значение которой необходимо спрогнозировать;
- «Норм. цена откр.», «норм. цена закр.», «норм. прогноз» – нормализованные значения.
Определение наиболее рациональной структуры базы данных проводилось экспериментальным (эвристическим ) путем.
Для различных вариантов структур базы данных для подсистемы нейросетевого прогнозирования котировок формировалось множество запросов на поиск определенных атрибутов информации (по одному полю и по множеству полей). При этом время обработки каждого одноаспектного или многоаспектного запроса фиксировалось.
После завершения реализации множества запросов для соответствующего варианта структуры БД оценивалось среднее время обработки множества запросов. Затем полученные значения сравнивались и выбирался тот вариант структуры БД, для которого значение среднего времени обработки множества запросов было минимальным.
Полученные значения усредненного времени реализации запросов приведены в табл. 4.3.
Таблица 4.3
Значения усредненного времени реализации запросов
Количество записей в базе данных:10000 |
|||||
Значения среднего времени выполнения запросов: мсек |
|||||
Поля не проиндексированы |
|||||
1НФ |
|||||
Цена открытия |
Нормальная цена открытия |
Цены закрытия |
Нормальная цена закрытия |
Прогнозная цена |
Нормальный прогноз |
700 |
790 |
775 |
770 |
680 |
700 |
3НФ |
|||||
Цена открытия |
Нормальная цена открытия |
Цены закрытия |
Нормальная цена закрытия |
Прогнозная цена |
Нормальный прогноз |
400 |
380 |
390 |
370 |
410 |
415 |
Все поля проиндексированы |
|||||
1НФ |
|||||
Цена открытия |
Нормальная цена открытия |
Цены закрытия |
Нормальная цена закрытия |
Прогнозная цена |
Нормальный прогноз |
518 |
500 |
490 |
530 |
515 |
530 |
3НФ |
|||||
Цена открытия |
Нормальная цена открытия |
Цены закрытия |
Нормальная цена закрытия |
Прогнозная цена |
Нормальный прогноз |
180 |
150 |
160 |
130 |
160 |
150 |